ZH
 ID
 EN
 AR

Oleh: A’la Syauqi
Bismillaahirrahmaanirrahiim
Akhir-akhir ini, kecerdasan buatan (Artificial Intelligence/AI) semakin dekat dengan aktivitas sehari-hari. Berbagai platform seperti ChatGPT, Google Gemini, Claude, dan DeepSeek dapat digunakan untuk menjawab pertanyaan, membantu menulis, menterjemahkan teks, merangkum dokumen, hingga berdiskusi menggunakan bahasa sehari-hari. Pengguna cukup mengetik kebutuhan atau pertanyaan, lalu AI akan meresponsnya. Caranya penggunaannya memang sederhana. Tetapi kemampuan tersebut dibangun melalui perkembangan teknologi yang panjang, khususnya upaya membuat komputer mampu memahami bahasa manusia. Usaha tersebut menjadi salah satu tujuan utama bidang Natural Language Processing (NLP) atau pemrosesan bahasa alami. Bidang penelitian yang berperan penting dalam mengembangkan kemampuan AI untuk memproses dan menghasilkan bahasa manusia.
Tantangan Kompleksitas Bahasa Manusia
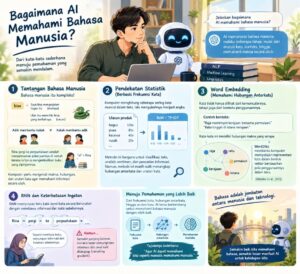
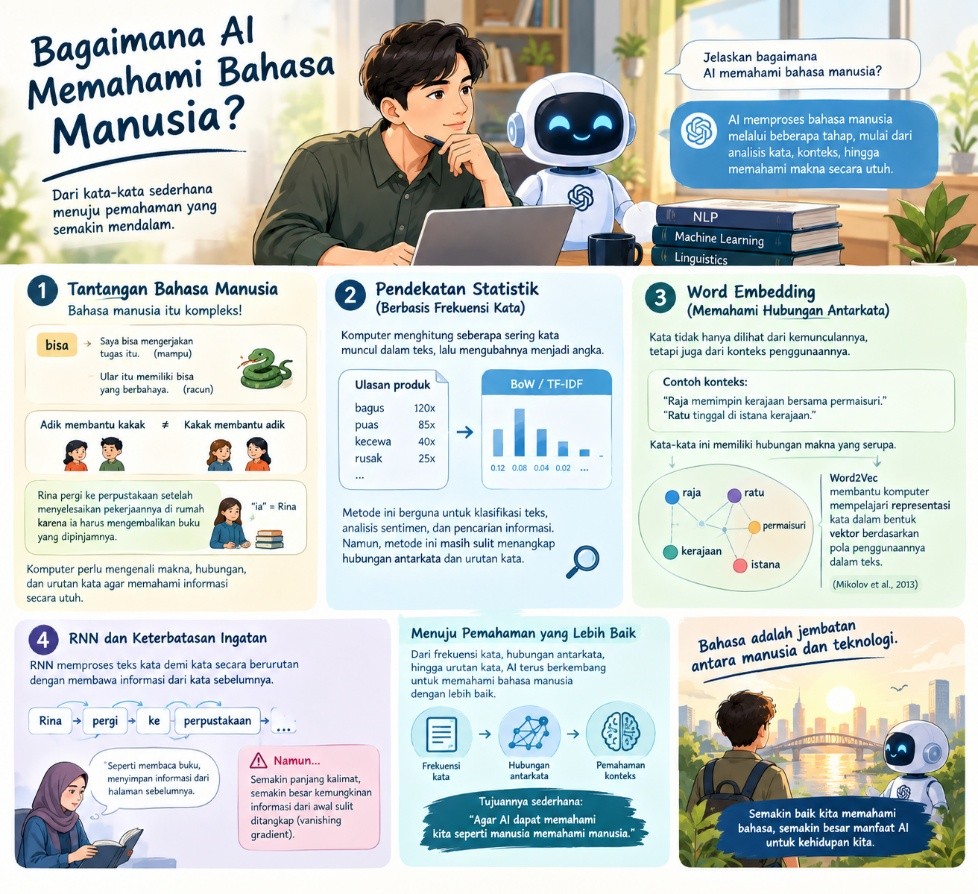
Bahasa manusia memang tidak sederhana. Sebuah kata dapat memiliki makna berbeda tergantung pada kalimat yang menggunakannya. Misalnya, kata “bisa” pada kalimat “Saya bisa mengerjakan tugas itu” berarti ‘mampu’, sedangkan pada kalimat “Ular itu memiliki bisa yang berbahaya” berarti ‘racun’. Urutan katanya juga dapat mengubah makna. “Adik membantu kakak” memiliki arti yang berbeda dengan “Kakak membantu adik”, meskipun kata-kata yang digunakan hampir sama. Apalagi ketika ketika kata-kata yang saling berkaitan berada cukup jauh dalam sebuah kalimat. Misalnya, pada kalimat “Rina pergi ke perpustakaan setelah menyelesaikan pekerjaannya di rumah karena ia harus mengembalikan buku yang dipinjamnya”, kata “ia” merujuk pada “Rina” yang berada di awal kalimat. Komputer perlu mengenali hubungan seperti ini agar dapat memahami informasi yang disampaikan secara utuh.
Pendekatan Statistik (Berbasis Frekuensi Kata)
Di awal perkembangannya, komputer mencoba mengenali bahasa melalui pola kemunculan kata dalam kumpulan teks. Misalnya dari ribuan ulasan produk, komputer dapat mencatat seberapa sering kata seperti “bagus”, “puas”, “kecewa”, atau “rusak” muncul. Pola tersebut kemudian diubah menjadi angka agar dapat diproses oleh komputer.
Bag-of-Words (BoW) 和 Term Frequency-Inverse Document Frequency (TF-IDF) merupakan contoh metode yang digunakan untuk merepresentasikan teks. TF-IDF mengukur seberapa penting sebuah kata dalam suatu dokumen berdasarkan frekuensi kemunculannya dibandingkan dengan kemunculan kata tersebut di seluruh kumpulan dokumen (Salton & Buckley, 1988). Representasi ini dapat digunakan untuk berbagai keperluan, seperti klasifikasi teks (text classification), analisis sentimen (sentiment analysis), dan pencarian informasi (information retrieval). Dengan pendekatan ini komputer memang sudah terbantu untuk mengolah teks. Tetapi masih sulit untuk menangkap hubungan antarkata dan urutan kata dalam sebuah kalimat.
Word Embedding (Memahami Hubungan Antarkata)
Keterbatasan tersebut mendorong metode yang lebih baik lagi untuk merepresentasikan kata. Komputer tidak cukup hanya mengetahui apakah sebuah kata muncul dalam teks. Komputer juga perlu melihat bagaimana kata tersebut digunakan bersama kata-kata lainnya. Gagasan ini dikenal sebagai distributional hypothesis, yaitu konsep bahwa kata-kata yang digunakan dalam konteks serupa cenderung memiliki hubungan makna yang serupa juga(Harris, 1954).
Misalnya, dalam kalimat “Raja memimpin kerajaan bersama permaisuri” 和 “Ratu tinggal di istana kerajaan”, kata “raja”, “ratu”, “kerajaan”, “permaisuri”, dan “istana” muncul dalam konteks yang berkaitan. Dari pola tersebut komputer dapat mempelajari hubungan antarkata. Ide ini kemudian menjadi dasar munculnya word embedding, yaitu cara merepresentasikan kata dalam bentuk angka atau vektor berdasarkan pola penggunaannya dalam kumpulan teks. Salah satu model yang menggunakan pendekatan ini adalah Word2Vec, yang mampu mempelajari representasi kata dari kumpulan teks berukuran sangat besar (Mikolov et al., 2013). Representasi tersebut membantu komputer menangkap hubungan antarkata dengan lebih baik dibandingkan metode yang hanya mengandalkan frekuensi kemunculan kata.
RNN dan Keterbatasan Ingatan
Memahami sebuah kalimat tidak cukup dengan mengenali kata-kata penyusunnya. Komputer juga perlu memperhatikan urutan kata dan membawa informasi dari bagian yang sudah dibaca ke bagian berikutnya. Maka muncul ide pengunaan metode Recurrent Neural Network (RNN), yang memproses teks kata demi kata secara berurutan sambil membawa informasi dari kata-kata sebelumnya (Elman, 1990). Cara kerjanya dapat dianalogikan dengan seseorang yang membaca sebuah buku sambil mengingat informasi dari halaman-halaman sebelumnya.
Namun, ternyata “ingatan” RNN memiliki keterbatasan. Semakin panjang kalimat yang dibaca, semakin besar kemungkinan informasi dari bagian awal sulit dipertahankan ketika sampai pada bagian akhir. Bayangkan seseorang membaca buku yang tebal. Ia tidak mungkin mengingat semua hal yang telah dibacanya. Ia perlu memilih informasi mana yang penting untuk tetap diingat dan mana yang dapat dilupakan. RNN belum memiliki mekanisme khusus untuk melakukan hal tersebut.
Keterbatasan ini mendorong dikembangkannya dua varian RNN yang dilengkapi mekanisme gerbang (gates), yaitu Long Short-Term Memory (LSTM) (Hochreiter & Schmidhuber, 1997) dan Gated Recurrent Unit (GRU) (Cho et al., 2014). Gerbang tersebut membantu model menentukan informasi yang perlu dipertahankan dan yang dapat dilupakan. Kinerja LSTM dan GRU juga dapat berbeda bergantung pada implementasi pemrosesan yang diberikan (Chung et al., 2014).
Pemrosesan Dua Arah (Bidirectional)
Kelemahan arsitektur RNN, LSTM, dan GRU standar adalah pemrosesan teks dari satu arah (forward). Ketika sebuah kata sedang diproses, informasi yang digunakan terutama berasal dari bagian teks yang sudah dilewati. Padahal, kata yang berada setelahnya ada kemungkinan juga dapat membantu menentukan makna sebuah kata.
Sebagai contoh, pada kalimat “Kali itu airnya sangat jernih”, kata “airnya” membantu menunjukkan bahwa “kali” yang dimaksud adalah ‘sungai’. Bukan ‘kali’ lain misalnya “operasi aritmatika” atau “menyatakan banyaknya perulangan”. Ketika membaca dari awal ke akhir, informasi tentang “airnya” belum tersedia saat model memproses “kali”. Akibatnya, informasi yang dapat membantu menentukan makna “kali” belum tersedia pada saat kata tersebut diproses. Model bidirectional (forward-backward) dikembangkan untuk menggunakan informasi dari dua arah, yaitu dari awal ke akhir dan dari akhir ke awal (Schuster & Paliwal, 1997). Informasi dari kedua arah kemudian digabungkan sehingga setiap kata dapat diproses dengan mempertimbangkan konteks sebelum dan sesudahnya. Prinsip ini diterapkan pada LSTM menjadi BiLSTM (Graves, 2005), dan pada GRU menjadi BiGRU.
Encoder-Decoder dan Attention
Kemampuan membaca konteks dari dua arah membantu model memahami kalimat. Namun, dalam penerapannya seperti penterjemahan, model tidak hanya perlu memahami kalimat sumber. Model juga harus menghasilkan kalimat dalam bahasa lain dengan makna yang sesuai. Salah satu pendekatan yang digunakan adalah arsitektur encoder-decoder. Bagian encoder membaca kalimat sumber dan merangkum informasinya, sedangkan bagian decoder menggunakan informasi tersebut untuk menghasilkan kalimat keluaran. Contoh pendekatan ini telah digunakan dalam model sequence-to-sequence berbasis LSTM untuk tugas penterjemahan (Sutskever et al., 2014).
Yang menjadi permasalah dalam metode ini, seluruh informasi dari kalimat sumber perlu dirangkum dalam satu representasi. Mirip seperti merangkum paragraf yang panjang hanya dalam satu kalimat. Akibatnya semakin panjang paragrafnya, semakin besar pula kemungkinan detail penting yang terlewatkan.
Keterbatasan tersebut mendorong munculnya mekanisme attention. Mekanisme ini memungkinkan model melihat kembali bagian-bagian kalimat sumber ketika menghasilkan setiap kata keluaran. Model dapat memberikan perhatian lebih besar pada bagian yang paling relevan dengan keluaran yang sedang dihasilkan (Bahdanau et al., 2015). Pendekatan attention kemudian berkembang dalam berbagai bentuk, salah satunya perbedaan dalam menghitung tingkat attention untuk menyesuaikan kebutuhan pemrosesan bahasa (Luong et al., 2015).
Transformer (Attention adalah Kuncinya)
Perkembangan attention kemudian membawa perubahan besar dalam pemrosesan bahasa. Jika sebelumnya attention digunakan sebagai mekanisme tambahan pada arsitektur berbasis RNN, muncul ide untuk menjadikannya sebagai bagian utama dalam memproses hubungan antarkata. Ide ini diperkenalkan melalui model Transformer dalam penelitian “Attention Is All You Need” (Vaswani et al., 2017).
Transformer tidak lagi bergantung pada cara kerja RNN yang memproses kata secara berurutan dari satu kata ke kata berikutnya. Model ini menggunakan attention untuk melihat hubungan antarkata dalam sebuah kalimat. Sebuah kata dapat dikaitkan dengan kata-kata lain yang relevan tanpa harus menunggu kata-kata sebelumnya diproses satu per satu. Transformer juga memungkinkan beberapa bagian kalimat diproses secara bersamaan, sehingga pelatihan model dapat dilakukan dengan lebih efisien pada data dalam jumlah besar (Vaswani et al., 2017). Kemampuan tersebut membuat Transformer menjadi salah satu perkembangan penting dalam pemrosesan bahasa alami. Arsitektur ini kemudian menjadi dasar bagi berbagai model bahasa yang dilatih menggunakan data dalam skala sangat besar.
Ber-Transformer ke Large Language Models (LLM)
Transformer selanjutnya berkembang menjadi model bahasa dengan ukuran yang semakin besar. Model-model ini dilatih menggunakan teks dalam jumlah sangat besar. Seiring bertambahnya ukuran model, jumlah data, dan daya komputasi yang digunakan untuk melatihnya, kemampuan model dalam mempelajari pola bahasa juga cenderung meningkat (Kaplan et al., 2020).
Model bahasa dengan ukuran dan kemampuan yang sangat besar ini kemudian dikenal sebagai Large Language Model (LLM). LLM tidak hanya dapat digunakan untuk menghasilkan teks, tetapi juga dapat mendukung berbagai kegiatan seperti menjawab pertanyaan, menterjemahkan, merangkum, dan membantu menulis.
Lalu bagaimana hubungannya dengan ChatGPT? AI merupakan bidang yang luas, sedangkan LLM adalah salah satu jenis model AI yang dirancang untuk memproses dan menghasilkan teks bahasa alami. ChatGPT merupakan layanan aplikasi berbasis AI yang menggunakan model bahasa LLM dan dapat diakses dengan mudah oleh pengguna. Gemini, Claude, dan DeepSeek merupakan contoh lain penyedia layanan AI dengan kemampuan pemrosesan bahasa melalui model yang dikembangkan oleh perusahaan yang berbeda..
Kemampuan memahami bahasa manusia yang terlihat sederhana di layar gadget ini ternyata dibangun dari rangkaian riset panjang. Perkembangannya dimulai dari cara komputer menghitung kemunculan kata, kemudian berkembang menjadi kemampuan memahami hubungan antarkata, mempertahankan informasi, melihat konteks dari berbagai arah, hingga memproses bahasa menggunakan model yang dilatih dengan data dalam skala sangat besar.
Wallahu a’lam bishawab
Referensi
Bahdanau, D., Cho, K., & Bengio, Y. (2015). Neural machine translation by jointly learning to align and translate. Dipresentasikan pada International Conference on Learning Representations (ICLR 2015), San Diego, CA. https://arxiv.org/abs/1409.0473
Cho, K., van Merriënboer, B., Gulcehre, C., Bahdanau, D., Bougares, F., Schwenk, H., & Bengio, Y. (2014). Learning phrase representations using RNN encoder-decoder for statistical machine translation. Dalam Proceedings of the 2014 Conference on Empirical Methods in Natural Language Processing (EMNLP) (hlm. 1724-1734). Doha, Qatar: Association for Computational Linguistics. https://doi.org/10.3115/v1/D14-1179
Chung, J., Gulcehre, C., Cho, K., & Bengio, Y. (2014). Empirical evaluation of gated recurrent neural networks on sequence modeling. Dipresentasikan pada NIPS 2014 Deep Learning and Representation Learning Workshop, Montreal, Canada. https://arxiv.org/abs/1412.3555
Elman, J. L. (1990). Finding structure in time. Cognitive Science, 14(2), 179-211. https://doi.org/10.1207/s15516709cog1402_1
Graves, A., & Schmidhuber, J. (2005). Framewise phoneme classification with bidirectional LSTM and other neural network architectures. Neural Networks, 18(5-6), 602-610. https://doi.org/10.1016/j.neunet.2005.06.042
Harris, Z. S. (1954). Distributional structure. Word, 10(2-3), 146-162. https://doi.org/10.1080/00437956.1954.11659520
Hochreiter, S., & Schmidhuber, J. (1997). Long short-term memory. Neural Computation, 9(8), 1735-1780. https://doi.org/10.1162/neco.1997.9.8.1735
Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., Chess, B., Child, R., Gray, S., Radford, A., Wu, J., & Amodei, D. (2020). Scaling laws for neural language models. arXiv. https://arxiv.org/abs/2001.08361
Luong, T., Pham, H., & Manning, C. D. (2015). Effective approaches to attention-based neural machine translation. Dalam Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing (EMNLP) (hlm. 1412-1421). Lisbon, Portugal: Association for Computational Linguistics. https://doi.org/10.18653/v1/D15-1166
Mikolov, T., Chen, K., Corrado, G., & Dean, J. (2013). Efficient estimation of word representations in vector space. Dipresentasikan pada International Conference on Learning Representations (ICLR 2013), Scottsdale, AZ. https://arxiv.org/abs/1301.3781
Salton, G., & Buckley, C. (1988). Term-weighting approaches in automatic text retrieval. Information Processing & Management, 24(5), 513-523. https://doi.org/10.1016/0306-4573(88)90021-0
Schuster, M., & Paliwal, K. K. (1997). Bidirectional recurrent neural networks. IEEE Transactions on Signal Processing, 45(11), 2673-2681. https://doi.org/10.1109/78.650093
Sutskever, I., Vinyals, O., & Le, Q. V. (2014). Sequence to sequence learning with neural networks. Dalam Advances in Neural Information Processing Systems (NeurIPS 2014) (Vol. 27, hlm. 3104-3112). Montreal, Canada. https://arxiv.org/abs/1409.3215
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Dalam Advances in Neural Information Processing Systems (NeurIPS 2017) (Vol. 30, hlm. 5998–6008). Long Beach, CA. https://arxiv.org/abs/1706.03762